商汤新模型实测:8分钟速读582页招股书,“卡”在了做PPT上
商汤新模型实测:8分钟速读582页招股书,“卡”在了做PPT上商汤发布多模态智能体模型SenseNova 6.8 Flash,实测其用8分21秒读完582页招股书并生成可交互看板,制作8页PPT却耗时64分钟,同时支持动态海报、Agentic 3D设计与Figma工作流。
来自主题: AI资讯
5958 点击 2026-11-04 11:12

 搜索
商汤发布多模态智能体模型SenseNova 6.8 Flash,实测其用8分21秒读完582页招股书并生成可交互看板,制作8页PPT却耗时64分钟,同时支持动态海报、Agentic 3D设计与Figma工作流。
最近,大模型圈的风向,彻底变了。
家人们,你们看下面这两张图,能分得出哪张是AI,哪张是真实的吗?
一款能走进真实工作的生图模型。
商汤首席科学家林达华在专访中判断,未来一两年多模态将迎来能力涌现的"GPT时刻",并阐述商汤以原生理解生成统一模型U系列和多模态智能体模型SenseNova 6.8为核心的长期技术路线。
商汤科技这次正式开源的SenseNova U1.5 Lite,其亮点如下:而且啊,SenseNova U1.5 Lite依旧保持了8B的大小,还能在复杂排版与精准编辑等核心的场景上比肩闭源的GPT-Image-2:

正式版将在近期推出并开源。
刚刚结束的 2026 年世界人工智能大会(WAIC) ,具身智能与 AI 终端占据了最显眼的位置,人形机器人、灵巧手和各类智能硬件吸引了大量目光。
光有强大的模型本身还不够,从脏数据到分析报告到汇报PPT,中间那条自动化链路谁来跑?GitHub上刚开源的SenseNova-Skills给出了一个答案,我们实测了四个真实场景,效果有点超出预期。
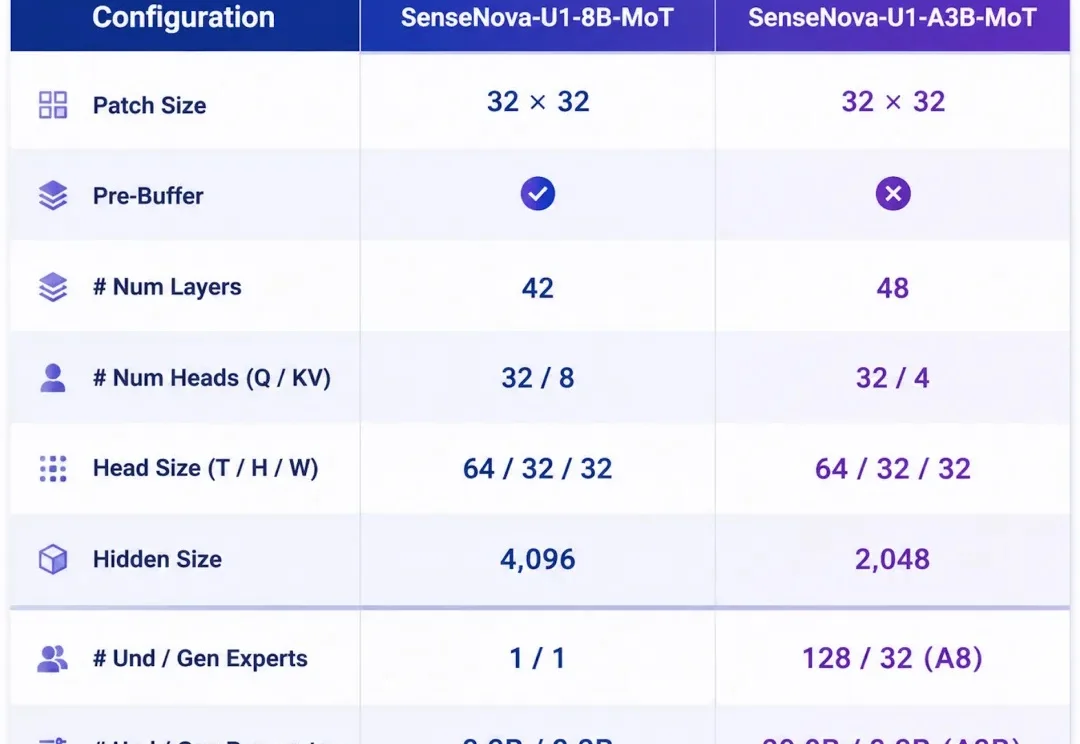
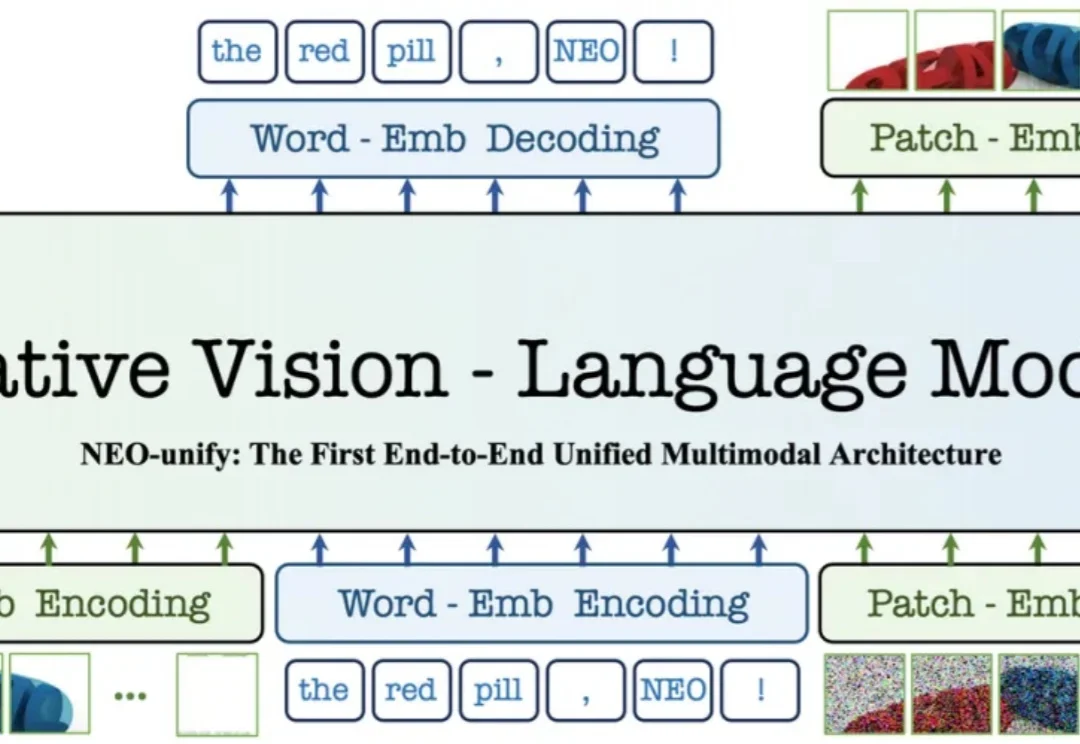
当 AI 行业的目光集中在 Agent、工具调用、长程任务这些上层应用之时,底层的多模态架构正在经历一次更安静、也更彻底的范式转变 —— 它要回答的是一个看似朴素的问题:理解与生成,是否天生就该是两件事?